谷歌发布 TPU 8tx 与 TPU 8i Max,扩展第八代 TPU 家族
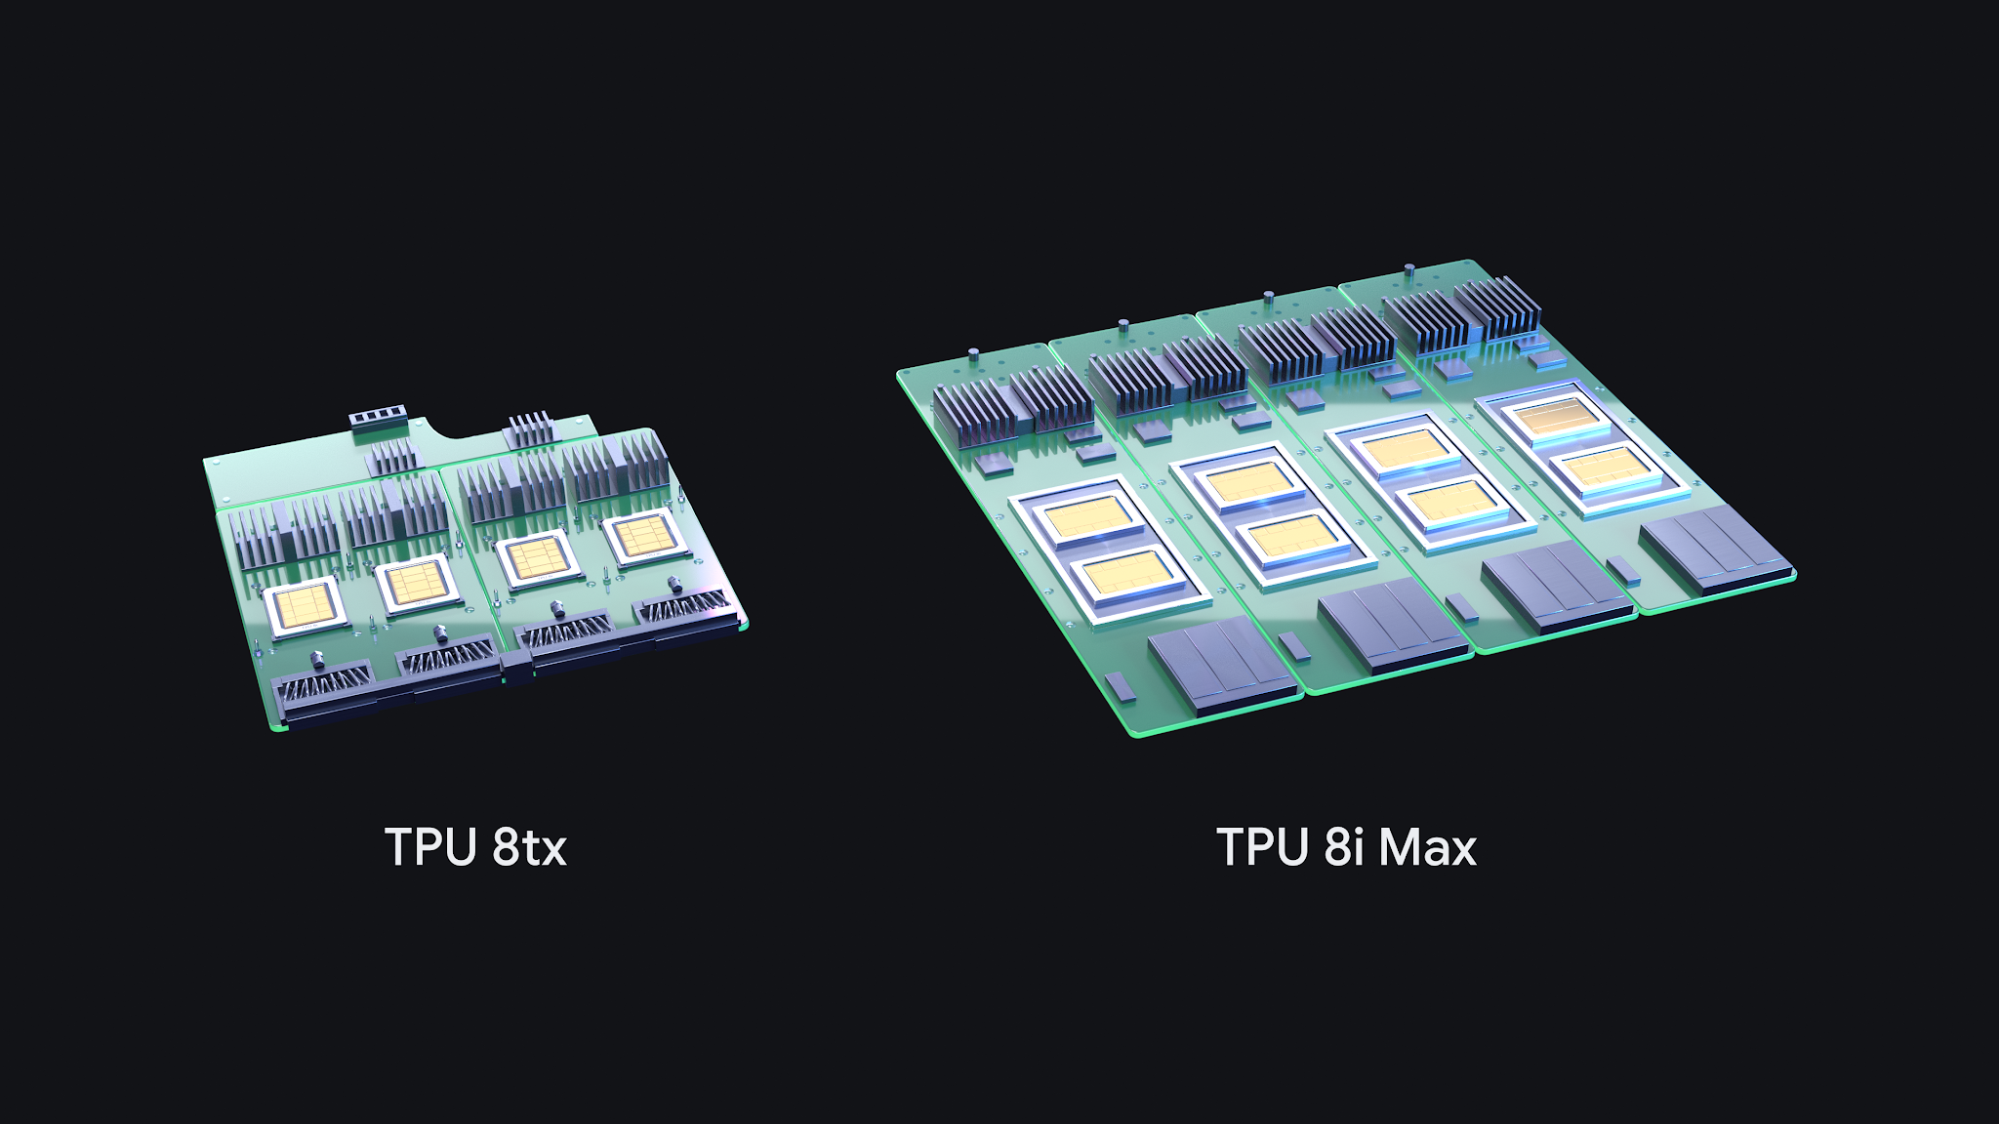
谷歌今日宣布扩展第八代 TPU 产品组合,新增 TPU 8tx 与 TPU 8i Max 两套系统。加上四月在 Google Cloud Next 上发布的 TPU 8t 与 TPU 8i,这是谷歌首次在一年内推出四套 TPU 系统。谷歌在公告中回顾,第一颗 TPU 设计于十多年前,最初用于语音识别与翻译;如今用途已扩展至训练和服务 Gemini 模型、agentic workloads、Google Cloud 客户服务,以及客户自有数据中心部署。目前 TPU 业务已有近 100 家客户,覆盖前沿实验室、交易公司、零售商与大学。此前发布的 TPU 8t 和 TPU 8i 分别提供最高 2.7 倍训练性能与 80% 推理性价比(相对上一代)。
TPU 8tx 面向安全与机密推理,也适合小规模训练。它基于与 TPU 8t 相同的硅片,搭配定制 AMD CPU 主机,将安全直接构建在硬件层,即使数据在活跃使用期间也能保护敏感数据和模型权重。与 TPU 8t 相比,TPU 8tx 采用低延迟 Boardfly 网络,延迟最多降低 2倍,且性能损耗接近为零。受监管企业和政府可以用同一系统运行前沿或专有模型、自主 agent 和敏感数据。由于训练级算力与快速推理网络结合,团队还能在同一系统上使用私有数据微调模型、将大模型蒸馏为小模型、通过强化学习训练 agent,无需在不同集群间迁移敏感数据。
TPU 8i Max 针对的是内存墙。当数十个 AI agent 同时处理整个代码库或数小时视频时,内存带宽会成为瓶颈。8i Max 将两颗低延迟 TPU 8i 芯片组合到单一封装中,计算、SRAM 和 HBM 带宽均为 TPU 8i 的两倍,让处理器持续获得所需数据,避免大任务停顿。由于在现有机架空间内装入了两倍硅片,数据中心可以在每平方英尺和每瓦特内部署显著更多的计算力。
软件层面,谷歌正在系统性降低 TPU 使用门槛。上月开源的 TorchTPU 让 PyTorch 代码与 Hugging Face 模型原生运行在 TPU,并为 vLLM、SGLang 等开源推理引擎提供开箱即用的 TPU 后端;新的开源 TPU agent suite(预览版)可直接接入 Claude Code、Cursor、Google Antigravity,用自然语言自动完成 TPU 上手指引、瓶颈诊断和内核自调优;新的开源 XLA Serving Engine 允许用 Python 训练模型,并在低延迟 C++ 运行时中跨 TPU、GPU、CPU 提供服务。在生产环境,原生 vLLM-TorchTPU 软件栈在行业标准 InferenceX 与 AgentX 基准上取得了 state-of-the-art 性价比,且覆盖多款前沿开源模型与开源 serving 框架。
针对自主 agent 的闲置浪费,Agent Compute Engine 软件会在 agent 等待数据库查询、外部工具或人工反馈时自动挂起空闲会话,并在毫秒级把工作内存移出芯片,降低运营基础设施成本。谷歌同时开源 TPU Sync,这是 TPU 集群的模型状态层:它把芯片 HBM、主机 DRAM、共享存储和数据中心网络统一成单一分层内存层次,自动将大规模 KV 缓存分层到芯片外,跨 disaggregated prefill 与 decode 节点流式传输上下文,并同步强化学习权重,将 KV 传输延迟和首 token 时间(TTFT)降低超过 90%。此外,Cloud Pathways 已在 Google Kubernetes Engine(GKE)上正式可用,单控制器架构支持跨多个 TPU slice 编排大规模分布式训练、RL 和多主机推理,并通过共置的 Python sidecar、sub-minute slice 热替换与弹性重分片维持长任务运行。同一批公告中,GKE dynamic slicing 正式可用。它利用光电路交换(OCS)技术,将物理硬件供给与逻辑 slice 形成解耦,动态把 TPU 立方体组装成更大拓扑(super-slicing)或拆分为更小隔离负载(sub-slicing),消除了手动重建节点池的循环。官方称任务启动时间最高缩短 5倍,故障恢复最高加快 4.5倍,提升整体集群利用率与 workload goodput。
谷歌认为,一年内交付四套 TPU 系统与统一开源软件栈,得益于芯片架构师、网络工程师、编译器团队与 Google DeepMind 研究人员的协同设计。谷歌还在用 TPU 驱动的 AI 服务加速下一代硬件开发:包括 Google DeepMind 的 AlphaChip 强化学习系统,以及用 Gemini 在数小时而非数周内生成芯片布局。四套系统覆盖 agent 生命周期的不同环节:TPU 8t 用于规模化训练,TPU 8i 用于低延迟推理,TPU 8tx 用于机密计算,TPU 8i Max 用于超大上下文与最高机架计算密度。