用 TRL 和 OpenEnv 训练编码模型画水彩
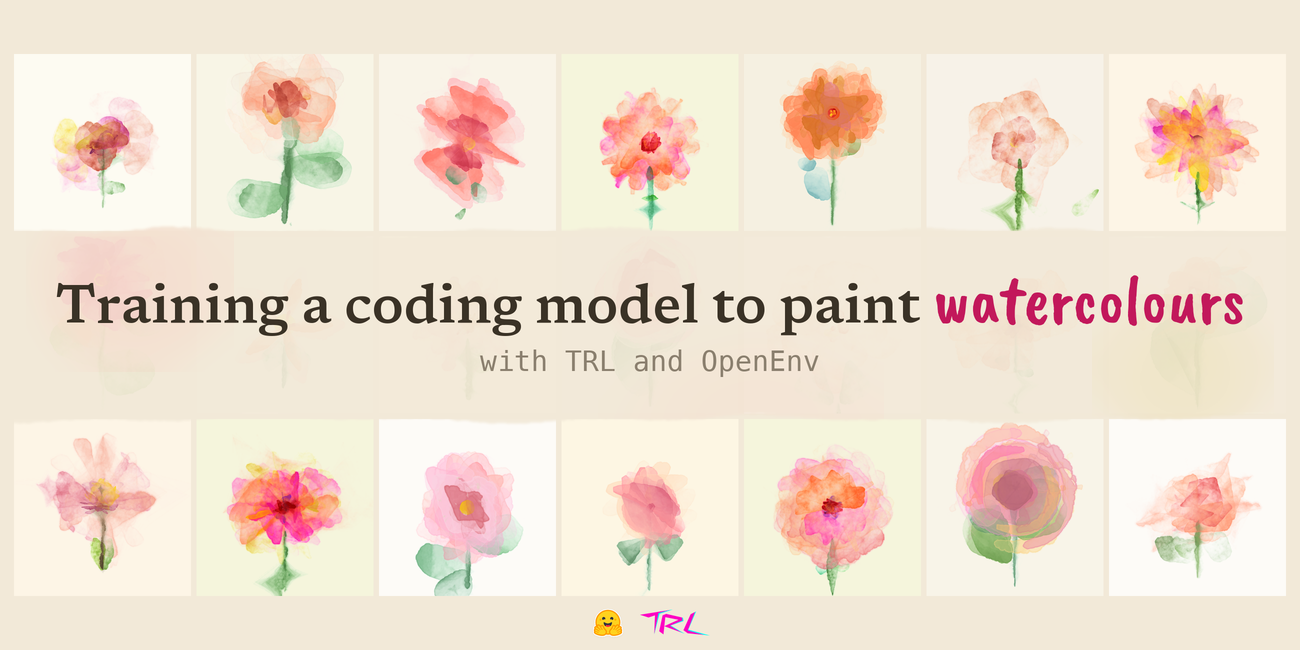
这篇文章详细记录了一个有趣的项目:使用 TRL(Hugging Face 的强化学习库)和 OpenEnv(开源 RL 环境框架)训练一个语言模型(基于 Qwen3.5-35B-A3B)通过 p5.brush 库编写 JavaScript 代码来绘制水彩画。作者完全复现了 Surya Narreddi 的想法,并将整个过程开源,包括数据集、RL 环境、训练脚本和训练好的模型。
项目的核心是通过 RL 来编码个人审美偏好(RL over taste)。奖励函数由四项组成:门控(画布必须正确渲染、不作弊)、代码长度(软性鼓励),以及两个模型打分的项目——pairwise judge(Qwen3-VL-30B-A3B)和 HPSv3(7B 审美偏好模型)。作者构建了一个包含 178 张由四款开放模型生成的绘画的参考池,并根据自己的喜好分为两档(love 和 okay)。pairwise judge 将候选画作与从池中随机抽取的四张参考画作进行比较,以此将个人的审美偏好注入奖励。
为了验证 pipeline,作者进行了三种奖励权重的实验:judge-led(pairwise judge 权重 0.6)、hps-led(HPSv3 权重 0.6)和 hps-only(仅 HPSv3,权重 0.9)。结果清晰展示了 weight 分配的效果:hps-only 提高了下限(减少了糟糕画作),但最好的画作质量基本不变(+0.03);而带有 pairwise judge 的两个 run 则同时提升了上限,最佳画作的中位数奖励分别上涨 +0.12 和 +0.16,并且颜料覆盖面积(paint coverage)从约 0.11 提升至 0.23–0.30。作者发现,问题的关键不在奖励函数本身,而在于定义奖励的参考池——它决定了模型认为什么是“好”的风格。
基础设施方面,整个 pipeline 运行在 Hugging Face 生态上,训练、两个 Space(环境和打分的 HPSv3)、Inference Providers 和一个 WebSocket 需要长时间保持健康。约 1.5% 的 rollouts 因渲染超时或打分失败导致奖励为 0,作者后来将这些失败改为返回 None 以避免噪声。作者还修复了 OpenEnv 中一个 WebSocket 缓存 bug 并提交了上游修复。成本方面,一个 110 步的 run 在 H200 上约 34 小时,渲染占时 70–80%。
最后给出了未尝试的改进思路:允许多轮交互(让模型看到自己的画作再迭代)、使用更小的模型(4B 已能生成有效草图)、在参考池中混合不同难度等。作者强调,这个方法的瓶颈不在模型或算法,而在于人为构建参考池这部分“没有原则性答案”的工作——正如 Jason Liu 所说,AI 将瓶颈从制造转移到了感知。