扩展印度语言预训练:2.8万亿token与开放数据生成流水线
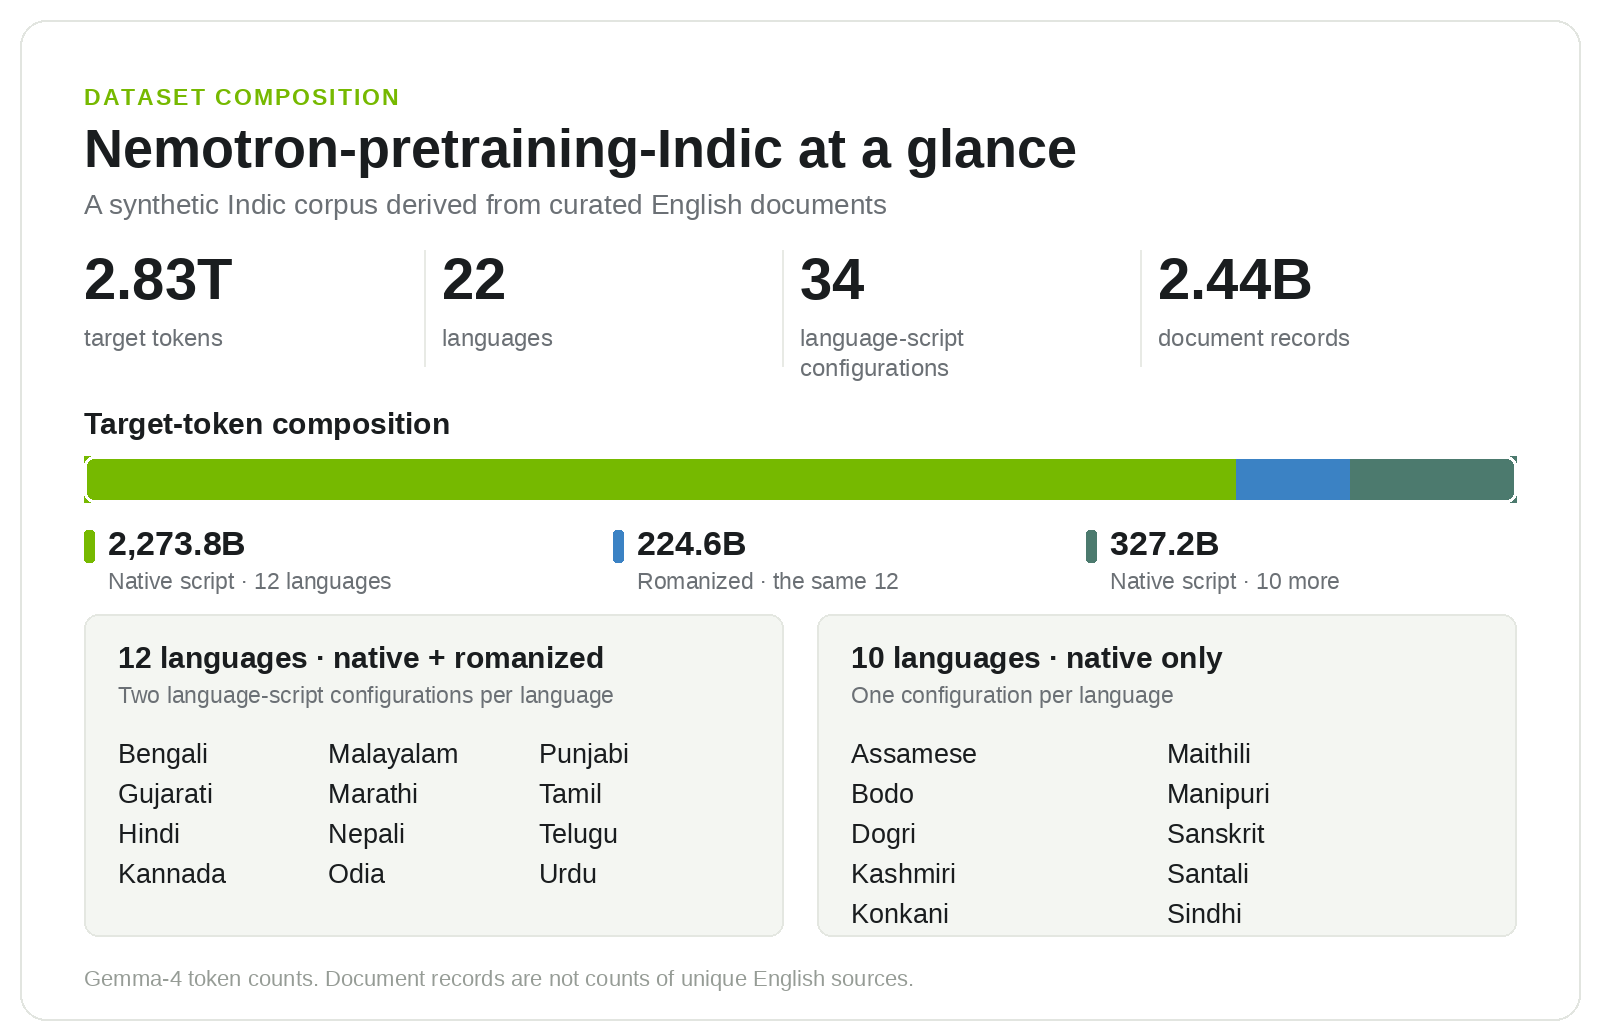
NVIDIA与IIT Madras的AI4Bharat实验室联合发布了Nemotron-pretraining-Indic-v1,一个覆盖22种印度语言、约2.8万亿token的预训练语料库。这22种语言是印度宪法列出的语言,根据2011年人口普查覆盖约97%的印度人口,近12亿公民。随语料库一并开源的还有一套GPU加速的数据生成流水线,包括提示词、LLM工作流和质量检查,开发者可以将其适配到自己的源材料上,生成更多同类数据。语料包含22种语言的本地文字(native-script)数据,并为其中12种语言附加罗马化(Latin script)文本,共构成34种语言-脚本配置。
语料库总计2601.0亿本地文字token和224.6亿罗马化token,计数采用Gemma-4 tokenizer。需要区分的是,这些数字是语料库存量,不是训练时的token预算;且同一英文源文档的翻译和脚本变体会产生多条记录,因此不代表唯一英文文档数。数据源自15个Nemotron-CC-v2子集,涵盖网页、问答、数学、代码和专业内容。流水线用NVIDIA的开源框架NeMo Data Designer执行翻译、质量评估和修复,每条记录都保留源文档ID,使生成数据可追溯、可审计。
对于孟加拉语、印地语、泰米尔语等12种双文字语言,工作流使用Gemma-4-31B-it对整个文档进行翻译,以保留段落、表格和方程级别的上下文。提示词明确区分需要翻译的散文与需要原样保留的内容(代码、方程、URL、格式)。翻译后,同一模型按MQM(多维质量指标)风格对含义、流畅度、术语、风格和格式评分,75分为通过阈值。低于阈值的输出由反馈引导修复,再重新评估。这一修复过程在原生文字和罗马化数据中回收了438.4亿token。罗马化采用两步法:先翻译成原生文字,再转写为拉丁字母。初步人工对比显示,两步法比直接从英文生成罗马化文本产生更少的幻觉添加和残留英语。
其余10种语言使用Bodhan AI的Indic Translate文档级翻译模型,再由Gemma-4-31B-it评估,同样采用75分阈值,只产出原生文字数据,不做反馈式重写。为应对长文档和文字稳定问题,工作流做了适配:较长的桑塔利语文档按重叠窗口翻译后重建;曼尼普尔语先翻译成孟加拉文字,再转写为Meitei Mayek。
Nemotron 3.5 Super VL的继续预训练(CPT)阶段配置了1000亿训练token,其中10%(100亿token)来自本语料12语言子集和自然Indic文本的混合,其余900亿保持原训练混合比例。对比CPT前后的检查点,在MILU、Indic MMLU-Pro、Indic ARC-Challenge、Indic ARC-Easy、Indic GSM8K五个基准上分数全部上升,增幅为4.98到9.82个百分点。需要说明的是,这是合成加自然数据的整体阶段效果,不能单独归因于合成语料。与上一代Nemotron 3 Super相比,Nemotron 3.5 Super VL在六个任务基准中的五个上得分更高(知识、推理、数学、代码、翻译),IFEval 1.5下降2.04点;在IndiVibe四个语言质量维度上则全面改善。
开源部分包括NeMo Data Designer的Nemotron Bharat翻译插件,提供翻译和评估提示词、可选反馈式重写、文档分窗以及脚本重映射支持。开发建议从一小批自己的源文档开始,检查代码、数学和格式的保留情况,再由母语审阅者打磨提示词和检查规则,最后才规模化。生成与语料接受应视为两个步骤:插件产出候选和评分,进入训练语料的过滤策略由使用者自己决定。
官方明确列出的局限包括:翻译数据不能替代原本就用印度语言写成的文本,也无法保证覆盖本地知识和文化,应配合有来源的自然Indic文本使用。质量评估主要靠自动化,人工抽样覆盖率因语言而异;十二语言流程中翻译器同时担任评判者,保留文本仍可能有错误;十语言流程需要更多母语验证。源ID检查只去除处理重复,不做语义去重。配套方面,AI4Bharat正在建设开放的Indic-LLM-Eval-Suite基准集,用于评估模型的任务表现和语言质量。