定制SLM词表:实际应用推理成本降77%
生产环境中的自动评分器。一个基于Qwen3-4B的葡萄牙语论文自动评分器,接收论文、提示与辅助文本,输出各能力的等级和评分的JSON。模型已经针对任务微调,但tokenizer仍来自通用基座,面向多语言多场景。这带来两种浪费:领域高频内容被切碎;151,669个词条中大部分几乎用不到,每次生成都要计算分值。本文是VocabX论文的预览,数据来自仍未正式发表的版本。
为什么生成token更贵。推理分两个阶段:prefill阶段权重读取可被输入token复用,瓶颈在算力;decode阶段每生成一个token就要完整过一遍网络,权重读取利用率低,瓶颈在内存带宽。这种效应在小模型、中等批次服务中尤为明显。测量显示,生成的token成本是读取的7.4倍,比例随硬件、批次、上下文变化,但方向确定:压缩输出远比压缩输入划算。此外,LM head矩阵约占Qwen3-4B参数量的近10%,每次生成都要读整个矩阵,多余词条照样付钱。
现有方法为什么不够。快速词表转移(FVT)、多词tokenization(MWT)和Liquid AI的in-place BPE都只解决碎片化,且选择token看频率不看成本;它们只操作一层,要么改切分,要么合并短语,没有在同一标准下同时做两层。评分器最大的浪费正是JSON envelope这类长重复片段,纯子词方法要一步步合并才能覆盖。
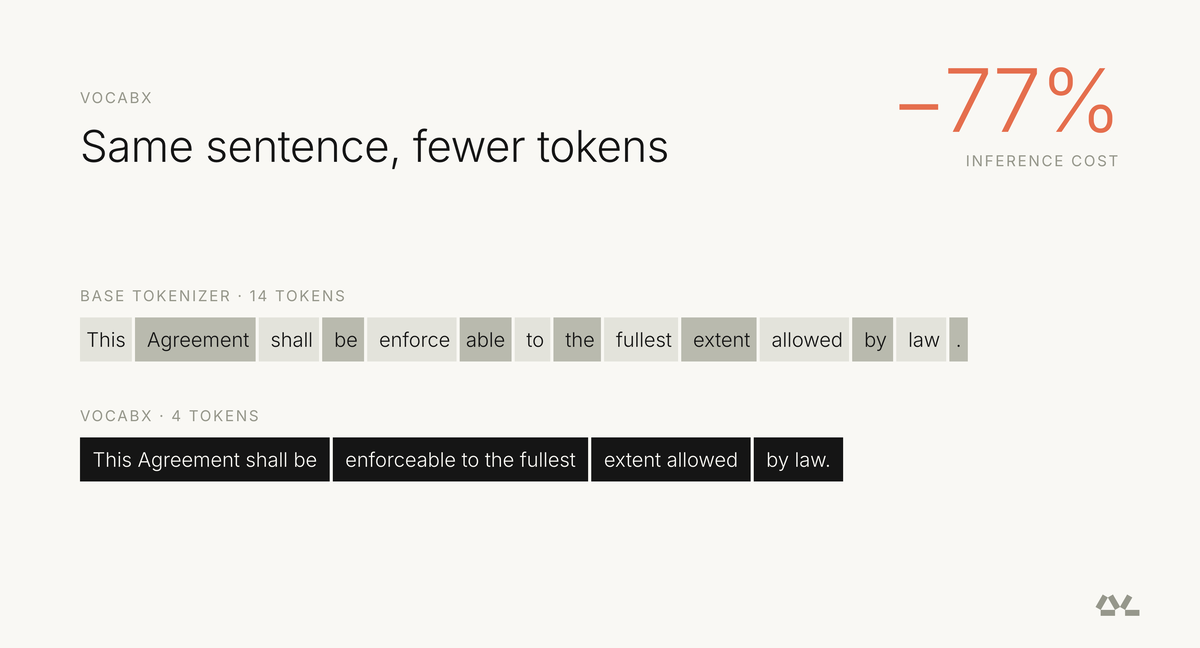
VocabX的做法。把选择标准改成每个token节省的成本和时间,而不是token数量。被消除的token按出现位置计入不同节省,响应中的token最值钱。两层并行:子词层重建领域词的切分;多词层把重复的长片段(短表达、整行、JSON envelope)设成宏token。用了五个miners分别找长词、整行、表达、句子和结构模式。对样本中看不到的候选,用统计估计替代零,仅这一项,合同语料压缩率从44.7%提升到52.8%。在生产评分器上,输出层从约152,000行降到约65,000行。
生产实验。用相同基座、数据、训练配方和种子,只换tokenizer,训练七个版本。在同一台RTX 5090上跑500个请求,vLLM服务,成本按实测运行时计算。模型响应从平均350 tokens降到101;成本降77.0%;bench score从0.703升到0.810。第一版把评级和JSON结构融合成一个宏token,最紧凑,但质量跌到0.689;把评级单独拆开,每个响应多付2 tokens,质量回升到0.810,成本反而更低(77.0%对比73.3%)。教训是:压缩掉模型赖以决策的信息会伤质量,目标不是最便宜的词表,而是保留关键token的前提下最便宜。
跨领域验证。在合同、医学论文、科学论文、新闻和Python代码五个公共语料上,用Qwen3、Llama-3.1和Gemma-3三个模型家族对比三种参考方法。VocabX在所有15个组合中压缩率多1.2到9.3个百分点;估计推理成本也全部领先,平均优势为Qwen3 10.2点、Llama-3.1 7.5点、Gemma-3 13.6点。合同语料上,pruned版本以113,426个词条达到62.6%压缩率,而最优in-place BPE用207,803个词条也只有61.8%。
结论。VocabX不会让模型更聪明,它只是让模型不再为用不到的文本逐词付费,也不再为用不到的词条打分。专业化可以始于词表,早于数据和权重。完整方法和实验表格将在论文中公布,本文数据来自正在评审的版本,后续可能调整。