同模型不同框架:CUGA 何时更合适?
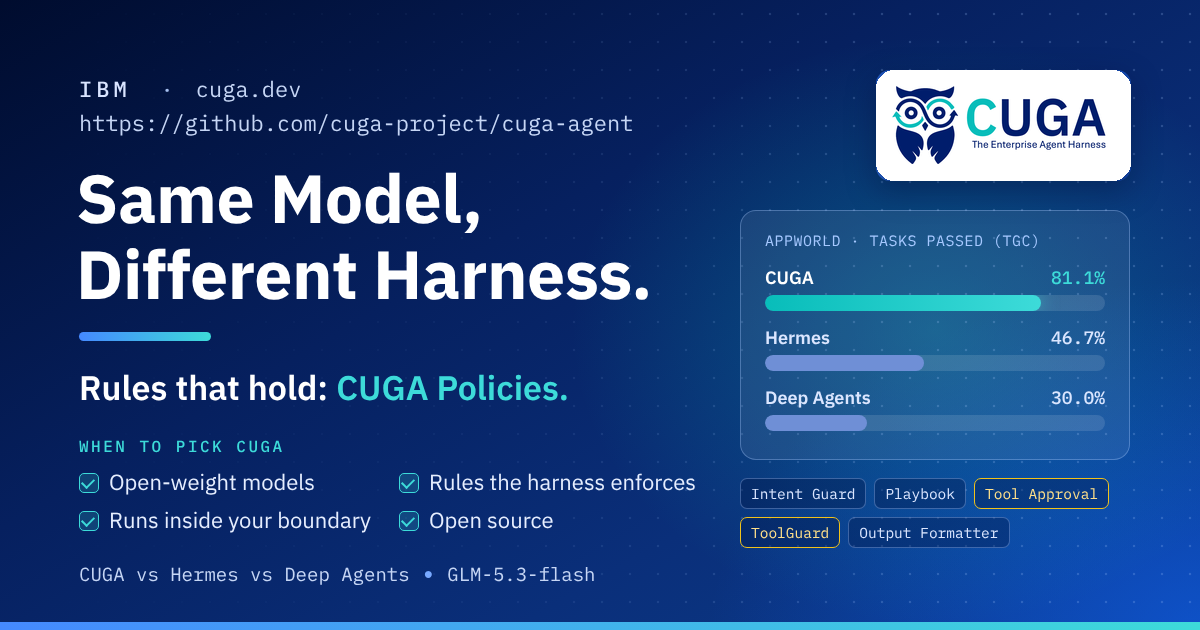
Agent harness(智能体执行框架)已经接近 200 个,而换框架带来的差距可能远大于换模型。best-of-Agent-Harnesses 引用的一项分析里,同一个 GLM-5.2 模型在 SWE-bench Pro 上只换 harness,成绩从 23% 变成 52%。IBM CUGA 团队做了更直接的对照实验:所有 harness 使用同一个 open-weight 模型 GLM-5.3-flash,在 AppWorld 上跑同样的 90 个任务、30 个场景,每个任务一次尝试。所有运行使用 Harbor evaluation framework,代码在 harbor-eval(Harbor fork)中公开。最终 AppWorld 完成率在 30% 到 81% 之间,差异全部来自 harness。
AppWorld 覆盖 9 个应用、457 个 API,任务涉及登录、阅读 API 文档、翻页、跨应用修改状态等。它测的是消费级应用,所以原文只把它当作企业自动化能力的代理测试。三个 harness 的配置并不一样:Hermes(Nous Research)和 Deep Agents(LangChain)都使用 AppWorld tools over MCP;Hermes 用 Harbor 默认配置,Deep Agents 另配了 LangChain 内置 middleware,包括工具选择、上下文摘要、待办列表、重试和调用限制,还修了两个会因 GLM 格式异常而中断运行的问题。CUGA 使用自己的 AppWorld 配置:任务分解、执行前验证、自动反思等。
结果有两个指标:TGC(任务通过)和 SGC(一个场景三个变体全部通过才算过)。TGC:CUGA 81.1%(73/90)、Hermes 46.7%(42/90)、Deep Agents 30.0%(27/90)。SGC:CUGA 66.7%(20/30)、Hermes 26.7%(8/30)、Deep Agents 6.7%(2/30)。SGC 更能反映稳定性,CUGA 与另外两个的差距也更大。作者明确说这不是对 Hermes 或 Deep Agents 的否定,它们都不为多应用 API 任务设计;关键是 harness 要匹配工作负载。实验也有三个限制:只测了一个基准的 90 个任务,可能不泛化;各 harness 配置不完全一致;运行时没有启用 policies,所以没有衡量规则执行。
企业场景是 CUGA 的主目标。作者认为企业 agent 操作 CRM、支付等业务系统,规则必须不依赖模型决定而成立。把规则写进 system prompt 只是指令,不是强制:模型可能误读,用户可能绕过,注入消息可能中途改变它。CUGA 的策略层在运行时四个点执行:Intent Guard 在用户意图层拦截请求;Playbook 给标准流程;Tool Approval 在工具执行前暂停等待人工批准;Tool Guide with ToolGuard 在工具前跑守卫代码,违规调用直接返回 policy violation,工具根本不会执行;Output Formatter 限定回复模板。审批和 ToolGuard 由运行时强制,不依赖模型。Policy Playground 有个例子:对“Pay everything I owe.”,无策略 agent 支付了 90 美元,其中包含一笔在催收流程中的拒赔;有策略的 agent 把支付挂起等待批准,最后只付了实际应付的 10 美元。策略层设计写入 ACM CAIS 2026 论文(arXiv)。
CUGA 的 agent 循环是 prepare、调用模型、执行、重复。这个循环可以从单个 CugaAgent 扩展到 CugaSupervisor 协调多个 agent(本地或通过 A2A 远程)。评测中起作用的 CUGA 特性包括:任务分解、聚焦工具(每一步只看到当前 app 的工具而不是全部 469 个)、工具短名单、CodeAct(模型写 Python 调用 API)、沙箱(限时执行)、执行前验证、自动反思、分页审计(列表调用返回整页却没有请求下一页时标记)。每个由 harness 控制的一步,都可以变成规则检查点。
作者给 CUGA 的定位是企业业务自动化:跨 API、应用和 Web UI,在可执行规则下运行。它兼容任意 OpenAI 兼容端点,可部署在本地、Kubernetes 私有或主权云、气隙主权集群,支持 OIDC、角色分离、预算上限和运行收据;源码 Apache 2.0。IBM Sovereign Core 基于 CUGA 构建。使用托管模型时,CUGA 在 WebArena(2025 年 2 月至 9 月)和 AppWorld(2025 年 7 月至 2026 年 2 月)保持第一。作者也列出何时不用 CUGA:终端编码 agent 用 opencode、Codex 或 Claude Code;常驻个人助手用 OpenClaw 或 Hermes;想要自由图框架则直接用 LangGraph。评测代码通过 harbor-eval 公开,他们欢迎任何人提交更好的 Hermes 或 Deep Agents 配置,并承诺在同一任务上重跑并公布结果。